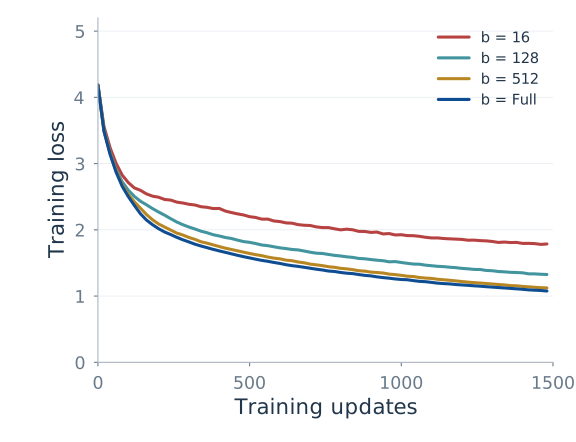
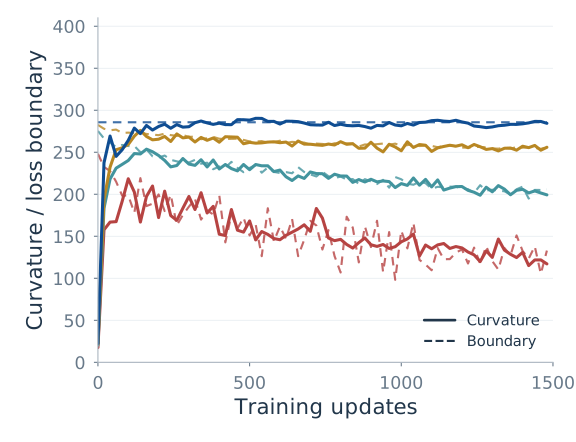
当优化器换成 Muon 时,在稳定性边缘附近训练会呈现怎样的图景? 先来看一个 130M 语言模型。观察下面三个面板随训练推进的变化:损失逐渐下降,测得的曲率接近损失平衡边界,而相邻更新方向的余弦在初期变化后,进入略低于零的区域。

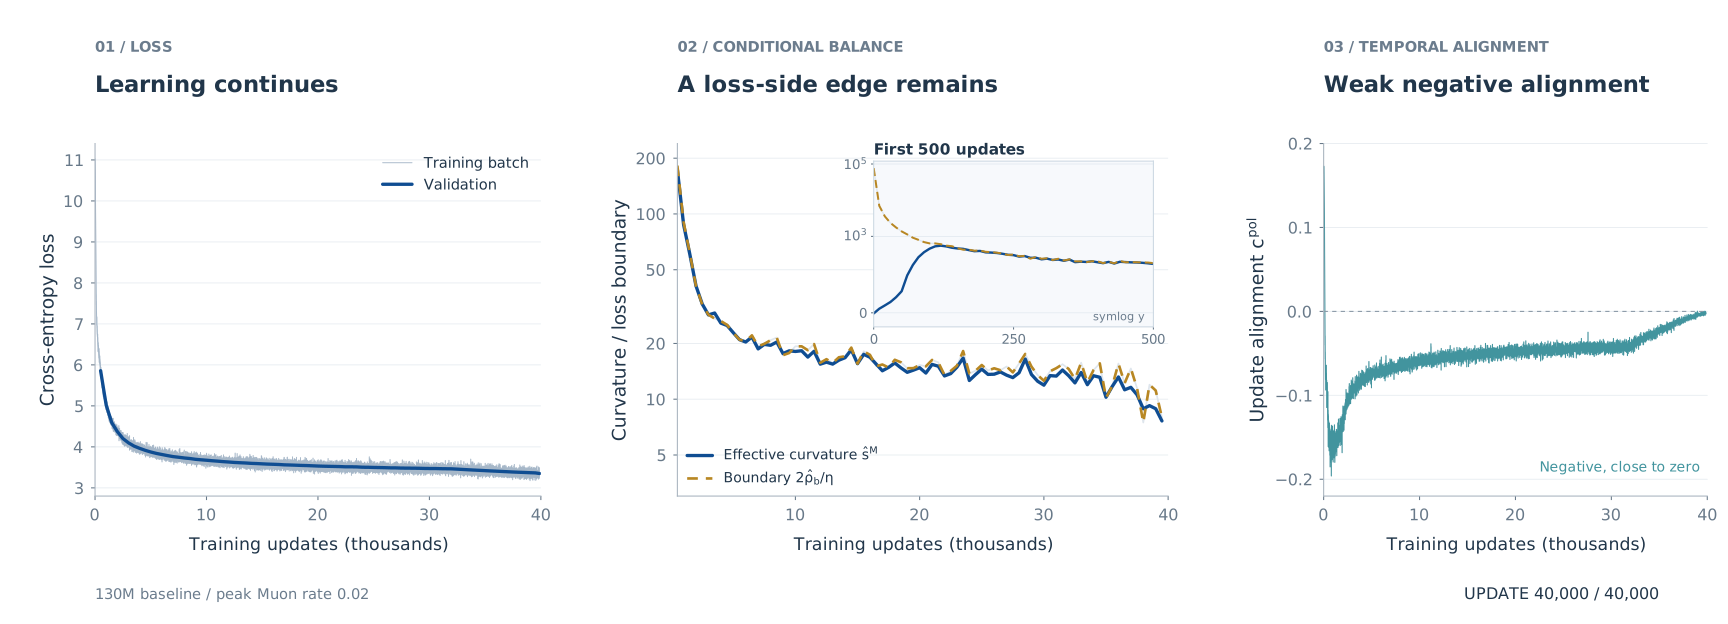 三幅图同步播放 · 早期更新慢放
先看中间面板:两条曲线在训练的大部分时间里相互跟随,内嵌小图展示了前 500 步的演化。再看右侧:经过初期过渡后,方向余弦保持为负,但很接近零。这意味着更新方向近乎正交,只带有较小的相互抵消分量。与此同时,左侧面板显示模型仍在持续学习。
为什么损失平衡边缘附近,会只有这么弱的方向反转? 为了理解这一点,我们先回顾熟悉的梯度下降例子,再看看 Muon 对矩阵梯度的变换改变了什么。由此,我们将引入两个量,分别解读损失和方向面板。最后再讨论:这些量能否帮助我们选择学习率和批量大小?
1. 什么是稳定性边缘?
设想以固定学习率训练神经网络。我们可能预期,训练始终处在每一步都能降低损失的区域。然而,全批量梯度下降经常表现得更出人意料:损失在短时间内波动,却在更长时间尺度上下降;Hessian 的最大特征值则停留在 \(2/\eta\) 附近。这就是 Cohen 等人(2021) 记录的稳定性边缘(Edge of Stability,EoS)现象。
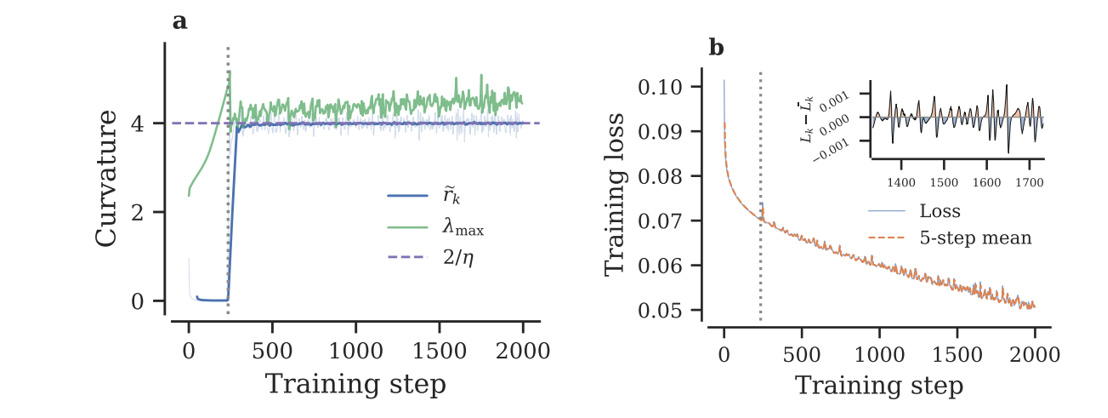
图 2 · 经典边缘附近,训练仍在取得进展。 先观察曲率接近学习率所决定的尺度,再比较损失的短期波动和长期下降。实验为全批量 GD、三层 MLP、CIFAR-10,学习率为 0.5。原图取自 Litman(2026)的图 1,按 CC BY 4.0 许可原样转载。
为什么会出现这个特定尺度?单个二次模态提供了一个简单的起点。
2/η 这个尺度从何而来?
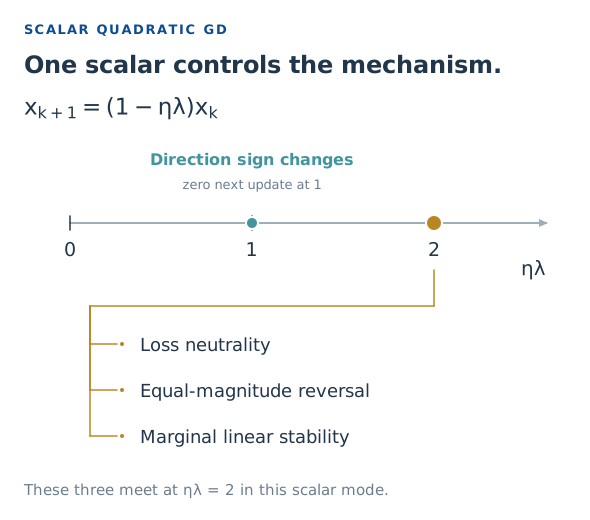
对于标量二次函数 \(L(x)=\lambda x^2/2\),GD 的更新为
\[x_{k+1}=(1-\eta\lambda)x_k.\]乘子 \(1-\eta\lambda\) 决定了该模态的幅度收缩还是增长。当 \(0<\eta\lambda<2\) 时,幅度收缩;超过 \(2\) 时,幅度增长。在 \(\eta\lambda=2\) 处,乘子恰好为 \(-1\):损失不变,相邻更新等幅反向,该模态处于临界稳定状态。这个简单计算解释了经典边界的尺度。
步长如何改变二次函数上的梯度下降
相同损失,不同步长。每个点按照 xₖ₊₁ = (1 − ηλ)xₖ,损失为 L(x) = λx²/2更新,其中 λ = 1。
ηλ = 0.8
无振荡地收敛
严格位于稳定边界内
ηλ = 1.8
振荡收敛
仅有振荡并不意味着到达边缘
ηλ = 2.0
临界:精确反向
通过步长设定在边界上
ηλ = 2.2
振荡发散
位于稳定边界外
简化示意。 四幅图的曲率均固定。这里仅解释标量稳定性阈值,并非展示神经网络如何自行接近或跟踪稳定性边缘;临界情形由步长直接设定。
观察 \(\eta\lambda=2\) 时的运动:每一步都落到极小点另一侧,而且距离相同。此时,损失不变与等幅反转重合。不过,方向反转在 \(\eta\lambda>1\) 时就已经出现,因此负余弦本身不能标识这个边界。当 \(\eta\lambda=1\) 时,下一步梯度为零,对应余弦没有定义。
找到边界,只是第一步
二次函数的计算告诉我们,一个局部模态何时不再收缩。神经网络实验还要回答另一个问题:训练轨迹是否真的会靠近并停留在边界附近,同时继续学习? 对 Muon 而言,我们既需要边界计算,也需要沿训练轨迹的测量。
这一区分也联系了两条已有研究线索。Wu、Ma 和 E(2018) 从线性化随机稳定性的角度研究训练会选择哪些极小点;Cohen 等人则研究训练轨迹上的 EoS 行为。下面以上述标量 GD 机制为参照,考察更新几何改变后,哪些联系仍然成立。
2. Muon 改变了不同方向上的相对更新强度
矩阵梯度在不同奇异方向上的强度可能差异很大。乘以一个学习率,会按同一比例缩放这些强度;Muon 则改变它们之间的相对大小。
在下图中,比较同一个输入圆分别经过梯度矩阵和其极因子后的像。梯度矩阵会在较强的奇异方向上产生更大的拉伸,而极映射把所有活跃奇异方向的强度都变为一。用紧致奇异值分解(SVD)可以明确写出这个操作:
\[\widehat G_k=U_r\Sigma_rV_r^\top, \qquad P_k=\operatorname{Pol}(\widehat G_k)=U_rV_r^\top, \qquad W_{k+1}=W_k-\eta P_k.\]它保留活跃的左右奇异向量,把非零奇异值替换为一。对整个梯度乘一个标量,会保留奇异值之间的比例;Muon 改变了这个比例。 零奇异方向仍然保持为零。
矩阵如何作用于方向
相同的奇异方向,不同的相对强度。
观察相同颜色的点:同一个单位圆,分别经过梯度矩阵 G 及其精确极因子映射。
原始梯度 G
奇异值
精确极方向 P
奇异值
\(W_{k+1}=W_k-\eta P_k.\) 变换作用于更新方向,权重矩阵本身并未被正交化。
实际的五步 Newton–Schulz 近似做了什么?
从经过 Frobenius 范数归一化的梯度出发,对每个奇异值应用 Muon 的五次多项式:
内部迭代 / 5
奇异值
这些是一次矩阵变换内部的迭代,以双精度计算,并非训练步。有限次五次多项式迭代不会得到严格等于 1 的奇异值;零奇异值仍保持为零。
交互展示的灵感来自 Mishra 的矩阵映射实验室 and Newton–Schulz 笔记;代码独立实现。另见 Bernstein 的推导.
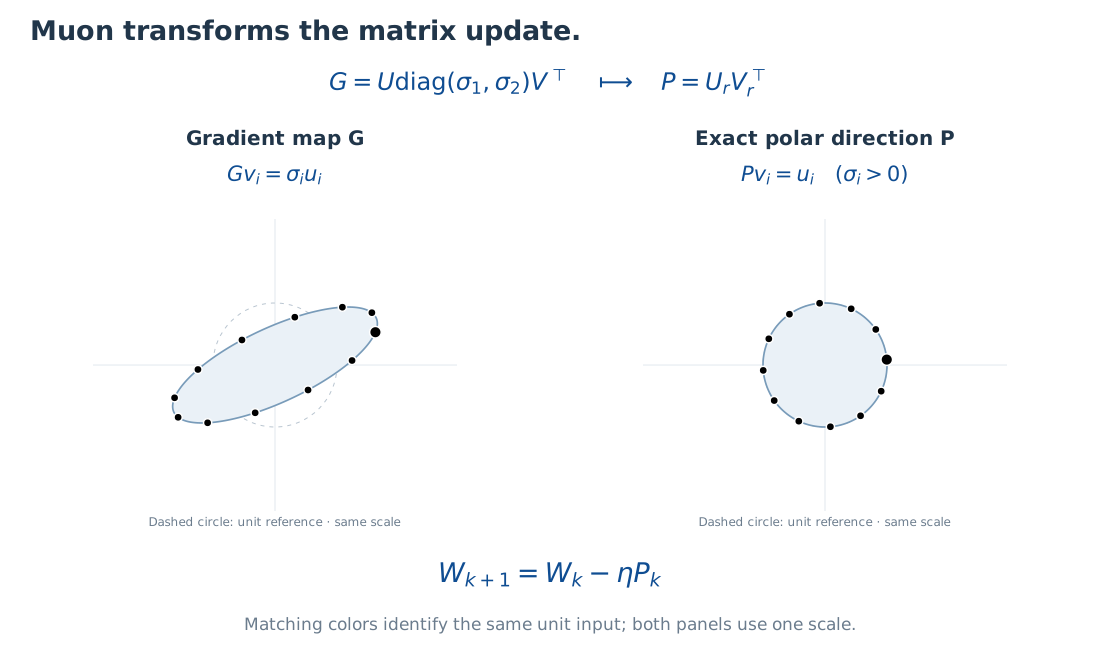
试着在图 3 中调整一个奇异值。梯度映射的形状随之变化,但精确极映射在活跃方向上的强度仍然为一。正是这种几何变化,使得标量 GD 的图景不能直接照搬过来。
这种变换为什么仍然给出下降方向?在以谱范数约束步长的条件下,极方向具有最速下降的解释:它最大化一阶下降量,
\[P\in\operatorname*{arg\,max}_{\|D\|_2\leq1}\langle\widehat G,D\rangle_F, \qquad \langle\widehat G,P\rangle_F=\|\widehat G\|_*.\]其中 \(\|D\|_2\) 是矩阵谱范数,\(\|G\|_*\) 是核范数。这也解释了下文的损失恒等式为什么包含核范数。受控实验使用 SVD 得到的精确极方向;语言模型训练采用实际使用的五步 Newton–Schulz 近似(NS-5),不使用动量。
为什么会出现核范数?
令 \(G=U_r\Sigma_rV_r^\top\)。对任意 \(\|D\|_2\leq1\),每一对活跃奇异向量都满足 \(\lvert u_i^\top Dv_i\rvert\leq1\)。于是
\[\langle G,D\rangle_F=\sum_{i=1}^{r}\sigma_i u_i^\top Dv_i \leq\sum_{i=1}^{r}\sigma_i=\|G\|_*.\]取 \(D=U_rV_r^\top\) 时等号成立。因此,在这一范数预算下,极方向使 \(-\eta D\) 对应的线性化损失变化最小。这里讨论的是无动量的精确极方向;近似变换并不会自动继承精确极映射的全部性质。更一般的逐层几何视角,可参考 Bernstein 对 Muon 的推导。
对于可微的优化器映射 \(F(W)=W-\eta T(\nabla L(W))\),
\[DF(W)=I-\eta\,DT(G)\circ\nabla^2L(W).\]GD 对应 \(T=\operatorname{Id}\)。非线性矩阵变换会引入自身的局部响应,而秩发生变化时还需要额外小心。这解释了为什么不能直接移植 GD 的机制;它本身并不是 Muon 的随机稳定性定理。
3. 经典图景中的联系为什么会分离?
现在可以提出两个具体问题:当前这一步会降低损失吗?下一步更新与这一步的方向如何对齐? 第一个问题使用当前方向;第二个问题还依赖下一状态产生的方向。
从左到右阅读下面的示意图。标量 GD 例子将损失平衡与等幅反转联系起来。对 Muon,我们需要分别用损失侧和方向侧的坐标描述状态。
从一个机制到两个诊断量
经典理论中的重合,变成两个坐标的问题。
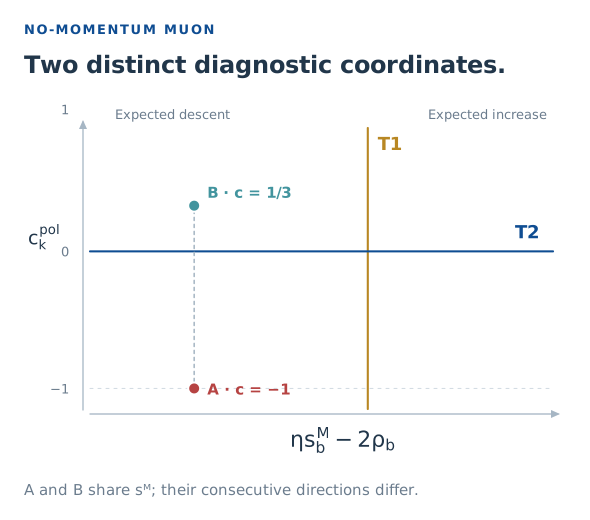
GD 的计算针对单个标量二次模态。Muon 图展示的是诊断坐标,而非扰动稳定性的相图,也不意味着每个点均可达到。A/B 对应图 5 的精确全批量构造,其中 ρ = 1。当 ηλ = 1 时,GD 的下一步更新为零,余弦没有定义。
T1:条件损失平衡边界
为了回答损失问题,设想把训练暂停在 \(W_k\),重新抽取大小为 \(b\) 的小批量。经过采样和极变换后,保留了多少有效的一阶下降信号?对非零全梯度 \(G_k=\nabla L(W_k)\),定义相干性
\[\rho_b=\frac{\mathbb E_b\langle G_k,P_k\rangle_F}{\|G_k\|_*}.\]它刻画采样与极归一化之后保留的一阶下降程度。采样梯度无偏,并不保证极方向也无偏。精确极映射的对偶性质给出 \(\rho_b\in[-1,1]\)。
有限步更新还会付出曲率代价。我们用损失余项定义的有效曲率 \(s_b^M\) 来概括这一代价。下降收益与曲率代价之间的竞争,给出如下精确恒等式:
\[\mathbb E_b[L(W_{k+1})-L(W_k)\mid W_k] =\frac{\eta^2\|G_k\|_*}{2}\left(s_b^M-\frac{2\rho_b}{\eta}\right).\]重点看括号内的量: 为负意味着期望损失下降,为零意味着平衡,为正意味着期望损失上升。因此,T1 为 \(s_b^M=2\rho_b/\eta\)。全批量精确极映射 Muon 满足 \(\rho_{\mathrm{full}}=1\),恢复 \(2/\eta\) 这一尺度。这里的有效曲率是归一化后的方向损失余项,并非 Hessian 的最大特征值。
条件损失恒等式的推导
定义有限步长余项
\[r_k(P)=L(W_k-\eta P)-L(W_k)+\eta\langle G_k,P\rangle_F.\]并令
\[s_b^M(W_k;\eta)=\frac{2\mathbb E_b r_k(P_k)}{\eta^2\|G_k\|_*}.\]整理余项并取条件期望,得到
\[\mathbb E_b\Delta L=-\eta\mathbb E_b\langle G_k,P_k\rangle_F +\mathbb E_b r_k(P_k) =-\eta\|G_k\|_*\rho_b+\frac{\eta^2\|G_k\|_*}{2}s_b^M.\]提取公因子即可得到正文中的恒等式。它要求目标函数连续可微、\(G_k\) 非零且相关期望有限,不依赖二阶 Taylor 近似。如果进一步满足二阶光滑性,则固定状态下的小步长极限为
\[s_b^M\longrightarrow\frac{\mathbb E_b\langle P_k,H_k[P_k]\rangle_F}{\|G_k\|_*}.\]这一等式定义了条件边界,但没有证明训练会停留在边界附近。实际的多矩阵块探针中,方向的数值归一化与有限参考目标遵循论文的实验协议,而非理想化的单矩阵计算。
T2:相邻方向的正交边界
再来看方向问题。用余弦比较当前更新与下一步更新。对于两个非零的相邻方向,
\[c_k^{\mathrm{pol}}=\frac{\langle P_k,P_{k+1}\rangle_F}{\|P_k\|_F\|P_{k+1}\|_F}.\]T2 是符号边界 \(c_k^{\mathrm{pol}}=0\)。正值表示夹角为锐角;负值表示夹角为钝角,相比同向更新存在部分抵消。离散轨迹可以跨越符号边界,而不恰好取到零。仅凭负余弦,既不能证明两步回到原点,也不能证明局部扰动稳定性。
观察图 4 中的两个箭头:正余弦表示相互加强,零表示正交,负余弦表示部分相互抵消。完全反转是其中一个特殊端点,并不是所有负值的含义。
从夹角到运动
余弦为负,仍然可以向前。


对 GD,方向符号边界与 \(1/\eta\) 的方向割线响应相联系。对全批量精确极映射 Muon,相应数值为依赖几何的 \(\vartheta_k/\eta\)。T1 和 T2 分别诊断损失与方向,不能把它们当作两个可以互换的线性稳定性判据。
从方向余弦到两步位移与割线边界
令 \(\Delta_k=W_{k+1}-W_k=-\eta_kP_k\),则
\[\|W_{k+2}-W_k\|_F^2=\|\Delta_k\|_F^2+\|\Delta_{k+1}\|_F^2 +2\|\Delta_k\|_F\|\Delta_{k+1}\|_F c_k^{\mathrm{pol}}.\]当 \(c=-1\) 时,Cauchy–Schwarz 等号条件给出两个方向反向且成比例。非零的精确极因子都具有单位算子范数,因此比例系数为一。在固定学习率下,得到 \(P_{k+1}=-P_k\) 以及 \(W_{k+2}=W_k\)。对实际 NS-5 方向或不相等的学习率,方向相反本身不一定意味着位移长度相等。
对全批量精确极映射 Muon,定义
\[\bar s_k^M=-\frac{\langle P_k,G_{k+1}-G_k\rangle_F}{\eta\|G_k\|_*}, \qquad a_k=\frac{\|G_{k+1}\|_*}{\|G_k\|_*},\qquad r_k=\operatorname{rank}(G_k).\]将下一步梯度分解为平均奇异强度对应的部分与残差:
\[R_{k+1}=G_{k+1}-\frac{\|G_{k+1}\|_*}{r_{k+1}}P_{k+1}, \qquad \vartheta_k=1-\frac{\langle P_k,R_{k+1}\rangle_F}{\|G_k\|_*}.\]利用 \(\|P_k\|_F^2=r_k\) 可得
\[\bar s_k^M=\frac{\vartheta_k-a_k\sqrt{r_k/r_{k+1}}\,c_k^{\mathrm{pol}}}{\eta}.\]因此,\(c_k^{\mathrm{pol}}=0\) 当且仅当 \(\bar s_k^M=\vartheta_k/\eta\);负余弦对应更大的割线响应。系数 \(\vartheta_k\) 不一定为一。这是给定更新步上的精确关系,不能仅靠一个曲率量给出普遍预测。当 Hessian 为常数时,损失曲率 \(s_k^M\) 与割线响应 \(\bar s_k^M\) 一致;一般情况下,它们对更新线段上的曲率赋予不同权重。详见论文附录 A.3。
相同损失曲率,不同的下一步方向
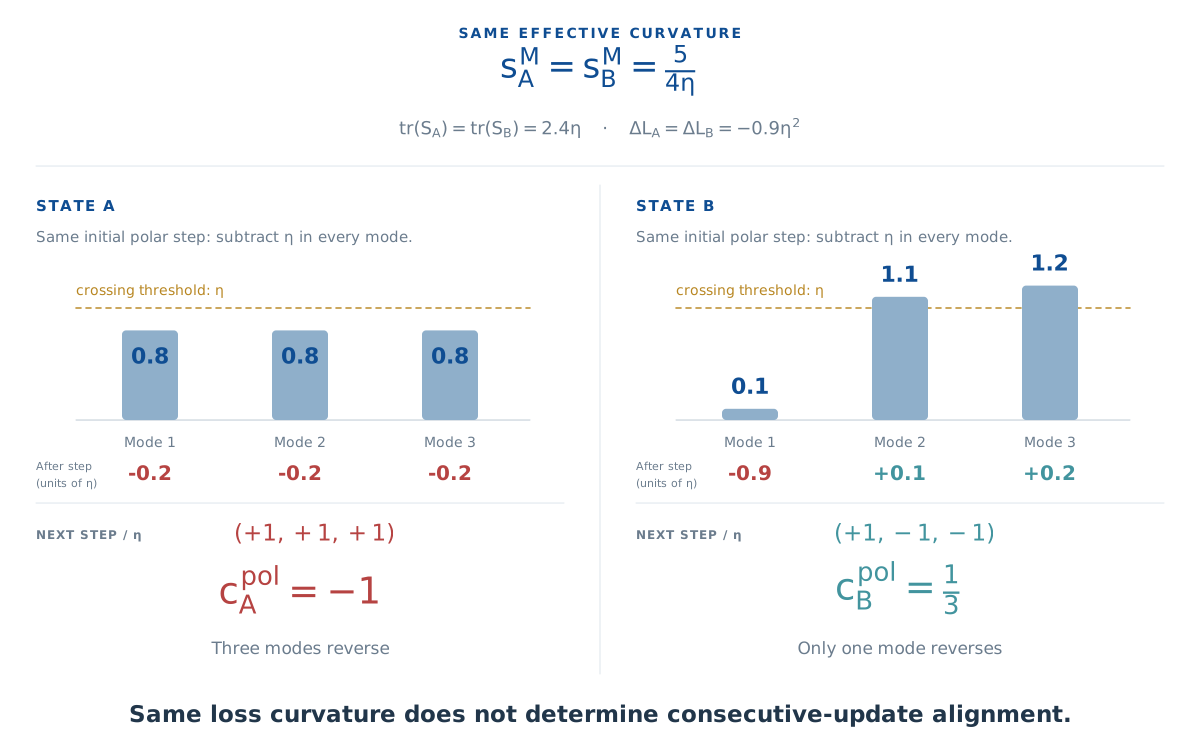
相同损失曲率真的可以对应不同符号的方向余弦吗?考虑论文中的 \(X=I_3\) 例子,将 \(W-W_{\min}\) 限制为对角矩阵,其带符号坐标记为 \(e_1,e_2,e_3\)。此时损失为 \(L=\tfrac12\sum_i e_i^2\),三个模态具有相同的二次函数形状。初始坐标均为正,因此两种状态下,精确极映射 Muon 都采取相同更新 \(\Delta_k=-\eta I_3\)。
无论初始强度如何,每个模态都向左移动 η。 在状态 A 中,三个坐标都越过零点,所以下一步三个方向全部反转。在状态 B 中,只有一个坐标越过零点,其余两个继续向左运动。方向余弦的差异由此变得直观。
关键对照是:有效曲率相同,更新方向的对齐程度却不同。 T1 依赖初始强度之和,即迹;方向余弦则依赖有多少个模态跨过零点。因此,同一平面 \(e_1+e_2+e_3=2.4\eta\) 上的两个初始点,可以拥有相同有效曲率,却产生不同的下一步方向。
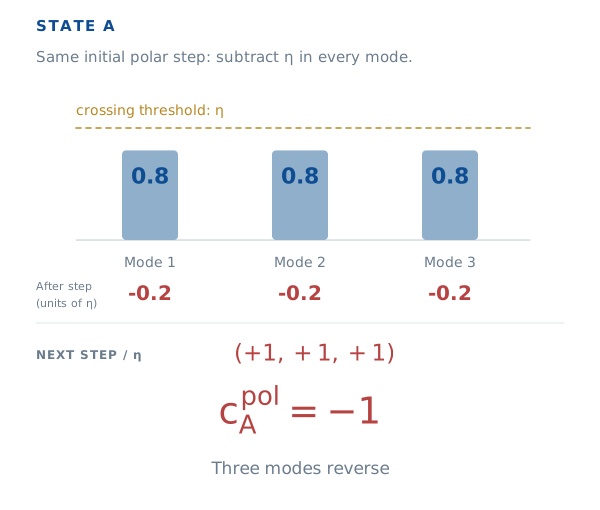
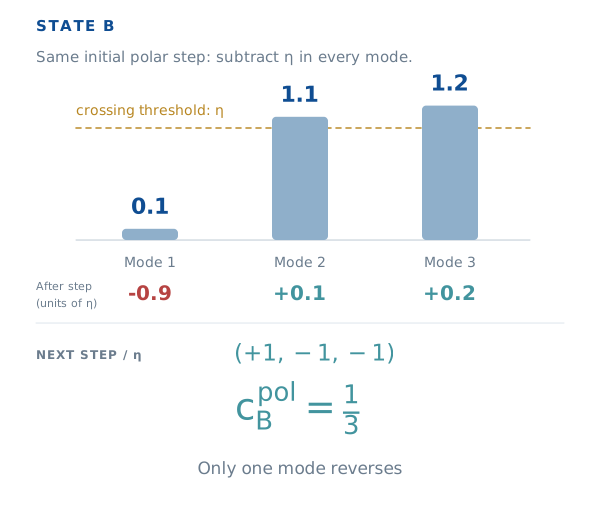
有效曲率相同,相邻更新的对齐程度却不同。
查看逐模态的二次模型构造
状态 A


状态 B


矩阵反例的完整计算
考虑 \(L(W)=\tfrac12\|WX-Y\|_F^2\),假设 \(XX^\top\succ0\)、\(m\geq d\),梯度满列秩,且 \(S_k-\eta XX^\top\) 非奇异。其中 \(G_k=P_kS_k\)、\(S_k=(G_k^\top G_k)^{1/2}\)。利用梯度的仿射结构,得到
\[G_{k+1}=G_k-\eta P_kXX^\top=P_k(S_k-\eta XX^\top).\]由于 \(P_k^\top P_k=I_d\),下一步的伸缩因子与极因子分别为
\[S_{k+1}=\lvert S_k-\eta XX^\top\rvert, \qquad P_{k+1}=P_k\operatorname{sign}(S_k-\eta XX^\top).\]绝对值和符号函数均逐特征值作用。二次损失展开给出
\[\Delta L=-\eta\operatorname{tr}(S_k)+\frac{\eta^2}{2}\|X\|_F^2, \qquad s_k^M=\frac{\|X\|_F^2}{\operatorname{tr}(S_k)}.\]若 \(n_-\) 表示 \(S_k-\eta XX^\top\) 的负特征值个数,则
\[c_k^{\mathrm{pol}}=\frac{\operatorname{tr}\operatorname{sign}(S_k-\eta XX^\top)}{d} =1-\frac{2n_-}{d}.\]取 \(X=I_3\),分别令 \(S_k=\eta\operatorname{diag}(0.8,0.8,0.8)\) 或 \(S_k=\eta\operatorname{diag}(0.1,1.1,1.2)\)。两者的迹均为 \(2.4\eta\),因此都有 \(s_k^M=5/(4\eta)\) 和 \(\Delta L=-0.9\eta^2\)。平移后的谱分别有三个和一个负特征值,得到 \(c=-1\) 与 \(c=1/3\)。这说明相同的损失曲率不能决定方向余弦。详见论文第 2.3 节与附录 A.2。
理论如何约束轨迹接近损失边界?
理论还给出一个轨迹约束。对下有界目标上的全批量精确极映射 Muon,若学习率固定,且累计活跃步权重 \(\sum_k\eta^2\|G_k\|_*\) 发散,则有效曲率不能最终一直与 \(2/\eta\) 保持固定的下方间隔:
\[\limsup_{k\to\infty:G_k\ne0}s_k^M\geq\frac{2}{\eta}.\]这一结论约束的是曲率对边界附近或以上区域的访问。随机 NS-5 训练中的持续边界追踪,仍然需要通过接下来的实验考察。
为什么曲率不能始终与边界保持固定的下方间隔?
假设所有足够晚的活跃步都满足 \(s_k^M\leq2/\eta-\delta\),其中 \(\delta>0\)。全批量相干性为一,因此损失恒等式给出
\[L(W_{k+1})-L(W_k)\leq-\frac{\delta}{2}\eta^2\|G_k\|_*.\]如果累计权重发散,对这些增量求和就会使损失趋向负无穷,与目标下有界矛盾。因此得到上述上极限不等式。它没有证明边界的吸引性、持续追踪性质,也没有给出时间方向余弦条件。详见论文附录 A.1。
4. 这两个诊断量在训练中如何表现?
矩阵例子解释了为什么一个量不能决定另一个量。现在沿训练轨迹同时观察它们。先从可以控制批量大小的小网络开始,再回到开头的语言模型实验。
受控网络:批量大小会改变事件顺序
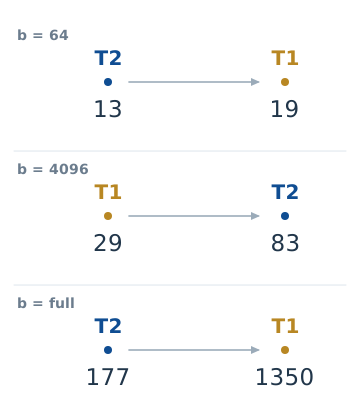
阅读图 6 时,对同一网络、同一批量大小,比较损失平衡与方向余弦。再用图 7 判断哪个事件先发生。
损失
损失平衡
相邻更新方向
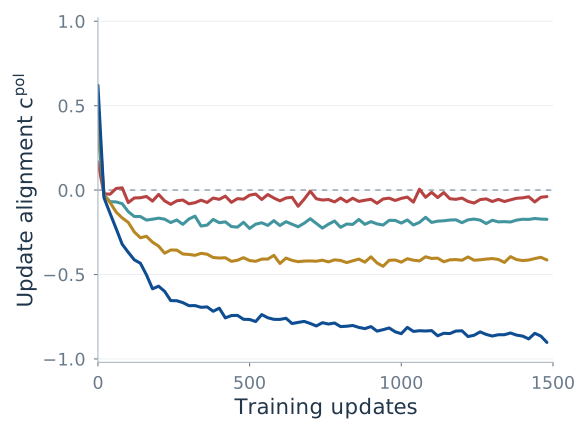
在这些实验中,小批量下的方向更接近正交,大批量则产生更负的方向余弦。图中的全批量全局测量接近一致反转,但没有达到 \(-1\)。
MLP
CNN
Transformer
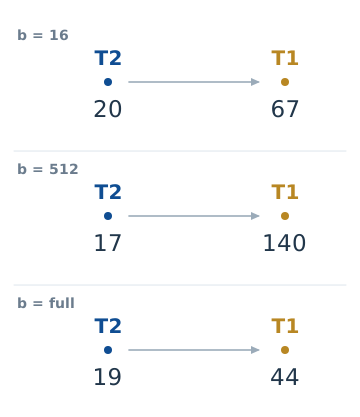
在数值坐标轴上比较原始事件时刻
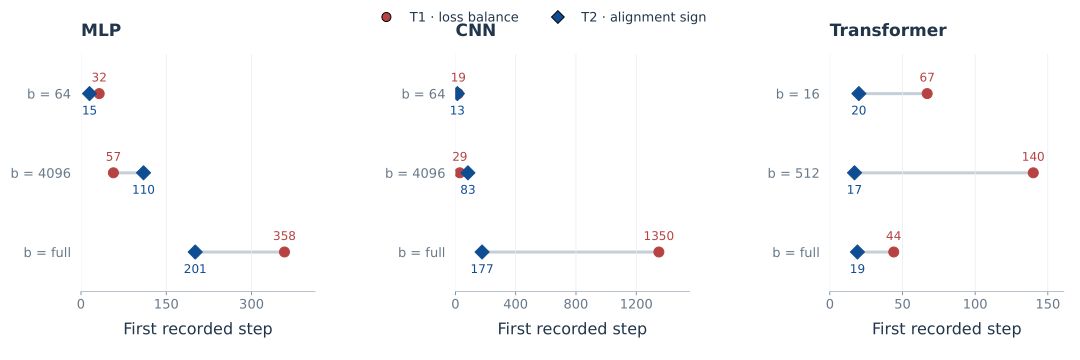
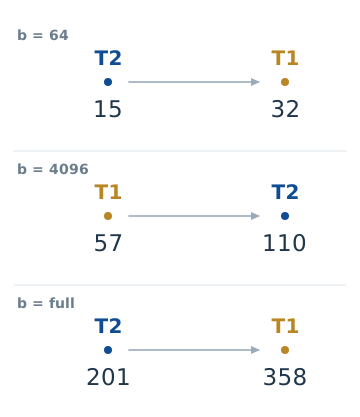
图中,MLP 和 CNN 在批量为 64 时先出现 T2、后出现 T1;在批量为 4096 时则相反。这展示了两个量在训练中的不同响应。仅凭事件发生时间不同,还不能证明二者分离:即使是标量 GD,也会先改变方向、再达到损失平衡。前面的矩阵反例提供了这一分离的证明。
语言模型:损失边界与弱负方向对齐并存
语言模型实验对 Muon 矩阵块使用无动量 NS-5,对辅助参数使用 AdamW。这些经验诊断补充了精确极映射分析,但不能把近似更新与理论更新视为完全相同。
| 实验 | 配置 | 重点观察 |
|---|---|---|
| 22M 检查点分支 | 学习率干预时批量为 16 | 损失变化可改变符号,而余弦仍保持负值 |
| 130M 训练 | 批量 32;序列长度 4096;约 52.3 亿 token | 条件边界追踪与全局弱负方向对齐 |
| 1B 训练 | 批量 512;序列长度 4096;约 200 亿 token | 余弦更负,但损失继续改善;未测量 T1 |
回到顶部的图 1。现在可以更准确地阅读它:中间面板关注条件损失平衡边界 T1,右侧面板刻画相对于正交边界 T2 的方向对齐。追踪前者,并不要求后者趋向 \(c=-1\)。左侧面板则显示,在这一方向状态下学习仍在继续。
四组峰值学习率实验中,全训练时段的余弦中位数约在 \(-0.048\) 至 \(-0.032\) 之间。核心经验图景是:持续为负、接近正交的方向对齐,与持续学习同时存在。
这里损失测量的范围有所不同。边界追踪来自有限参考目标上的 Muon 单独更新检查点探针;验证损失的改善来自完整的 Muon 与 AdamW 联合训练。条件探针的损失增量接近零,不代表整个模型已经停止学习。
当更新携带历史信息时,会发生什么?
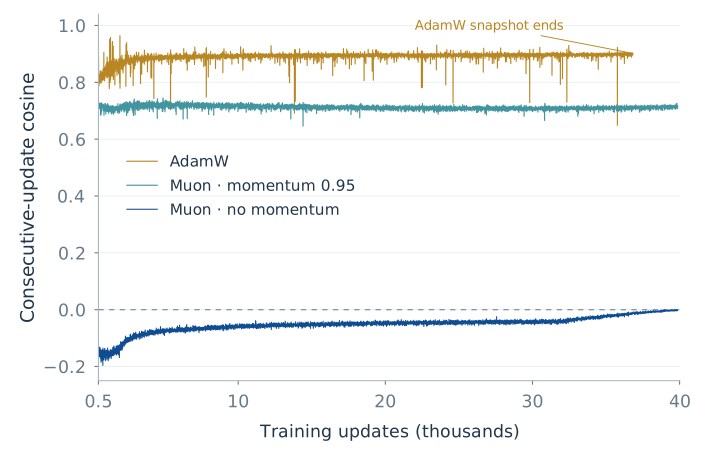
优化器带有记忆后,弱负对齐还会持续吗?新增的 130M 实验展示了不同的方向图景:动量为 0.95 的 Muon 和 AdamW,相邻更新均保持正向对齐。
在更新步 500–36,827 的共同窗口中,两者的平均全局余弦分别约为 0.712 和 0.891。两组实验中,每个已记录的全局余弦都为正;这一正号也出现在全部 12 层和 84 个独立矩阵块中,因此并非正负矩阵块相互平均造成的结果。
130M · 优化器的历史记忆
动量 Muon 与 AdamW 中的正向对齐
训练过程中的全局对齐
各层持续保持正值
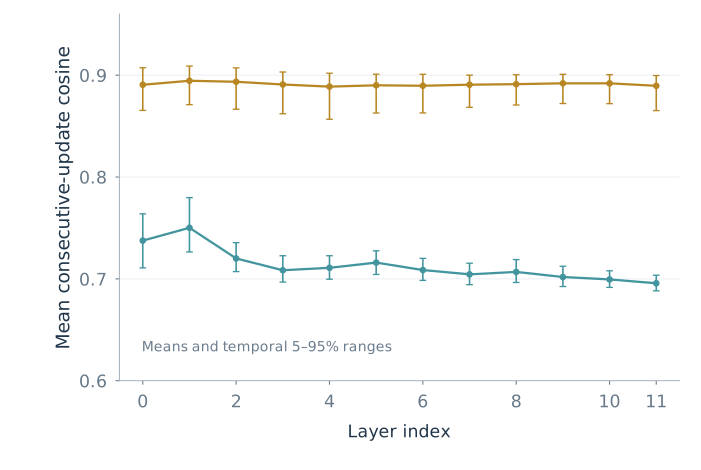
直觉是:动量更新继承了过去步骤的方向信息。 相邻更新复用了部分相同的梯度历史,因此即使新抽取的小批量发生变化,仍可能保持持续的正向对齐。AdamW 同样维护过去梯度的移动平均。对照图 1 中无动量 Muon 的弱负、近正交方向,优化器的记忆为方向行为引入了时间上的持续性。
5. 在同一检查点改变学习率
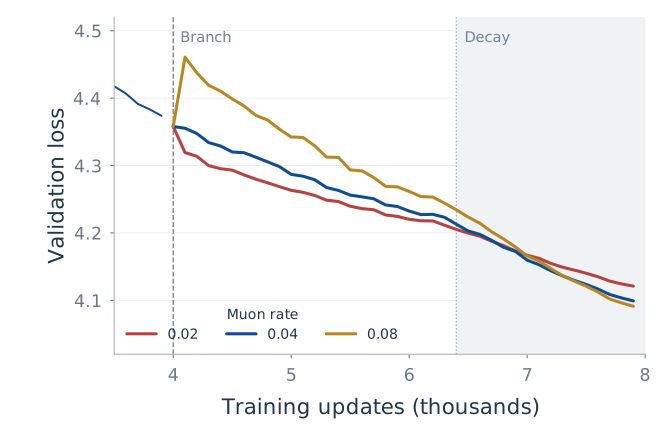
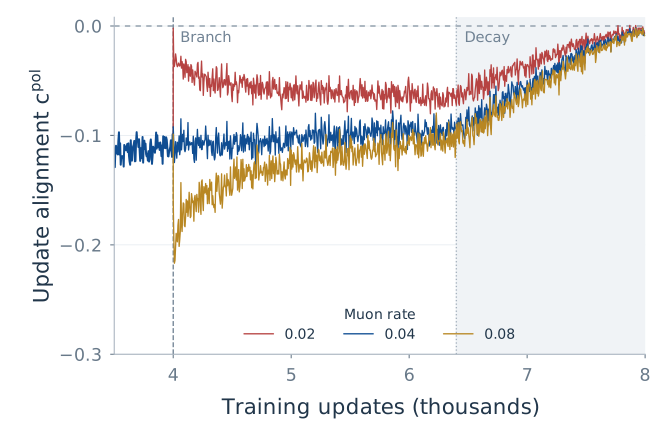
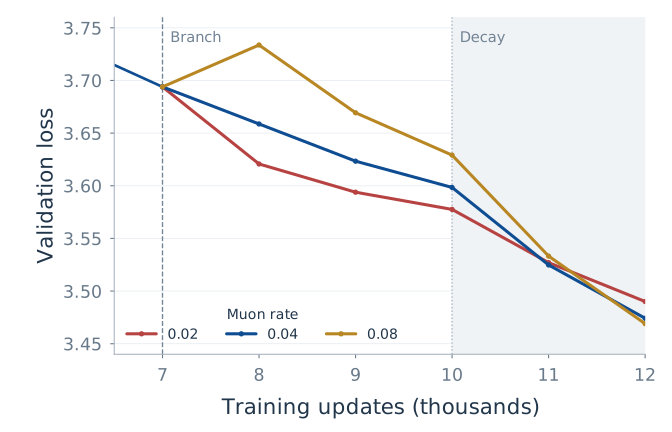
到目前为止,我们主要观察各个量如何共同演化。如果从同一个检查点出发,主动改变学习率,会发生什么?若损失平衡与方向对齐包含不同信息,改变其中一个,不一定意味着另一个发生相同变化。我们从学习率 0.04 分出 0.02、0.04、0.08 三个分支,固定各模型的批量大小与辅助 AdamW 调度。22M 的分支点为第 4000 步,130M 为第 7000 步。
22M 在第 4000 步的单步条件探针给出:
| Muon 学习率 | 条件损失增量 | 95% 探针区间 | 后续平均余弦 |
|---|---|---|---|
| 0.02 | −0.01967 | [−0.01999, −0.01936] | −0.064 |
| 0.04 | −0.00026 | [−0.00138, 0.00086] | −0.100 |
| 0.08 | +0.15219 | [0.14650, 0.15789] | −0.117 |
期望损失响应从下降跨越到上升,但三个分支的后续方向余弦都保持为负。 中间一组的区间包含零,较小与较大学习率分别位于损失边界的两侧。
各列对应不同时间尺度。区间来自同一状态下的八组配对单步探针,并非跨随机种子的不确定性。余弦均值汇总了每个分支在第 5000–6399 步记录的 280 对更新,未报告相应区间。130M 的学习率分支未进行条件 T1 探针测量。
22M · 从第 4000 步的同一状态分支
验证损失
相邻更新方向
130M · 从第 7000 步的同一状态分支
验证损失
相邻更新方向
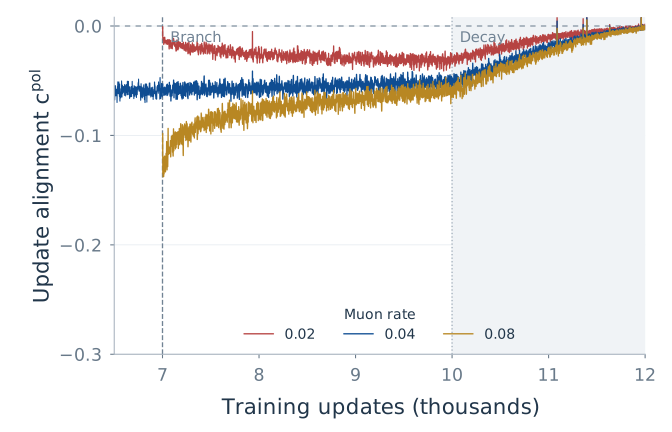
学习率改变首先引起方向余弦偏移,随后它又趋向改变前的数值。图中的两个模型后续也都进入了学习率衰减阶段,因此较晚的响应同时反映干预与调度的影响。部分较大学习率分支还改善了后续验证损失。这些观察为调度研究提供了动机,但尚不能推出“只要余弦接近零就应该提高学习率”的规则。
6. 噪声、层结构和模型规模带来哪些信息?
全局余弦仍留下几个问题:所有层都表现相同吗?近正交是否只是小批量随机性的结果?在更大模型上是否仍能看到这种模式?改变测量方式,可以分别考察这些问题。
全局平均会掩盖内部结构
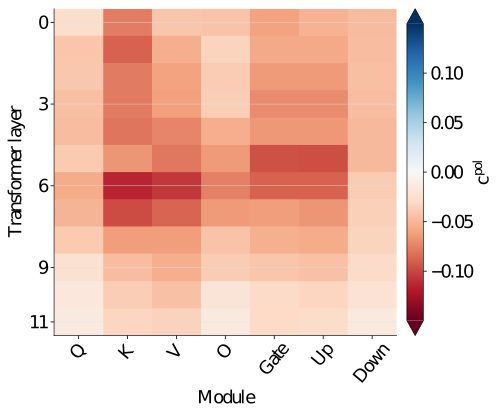
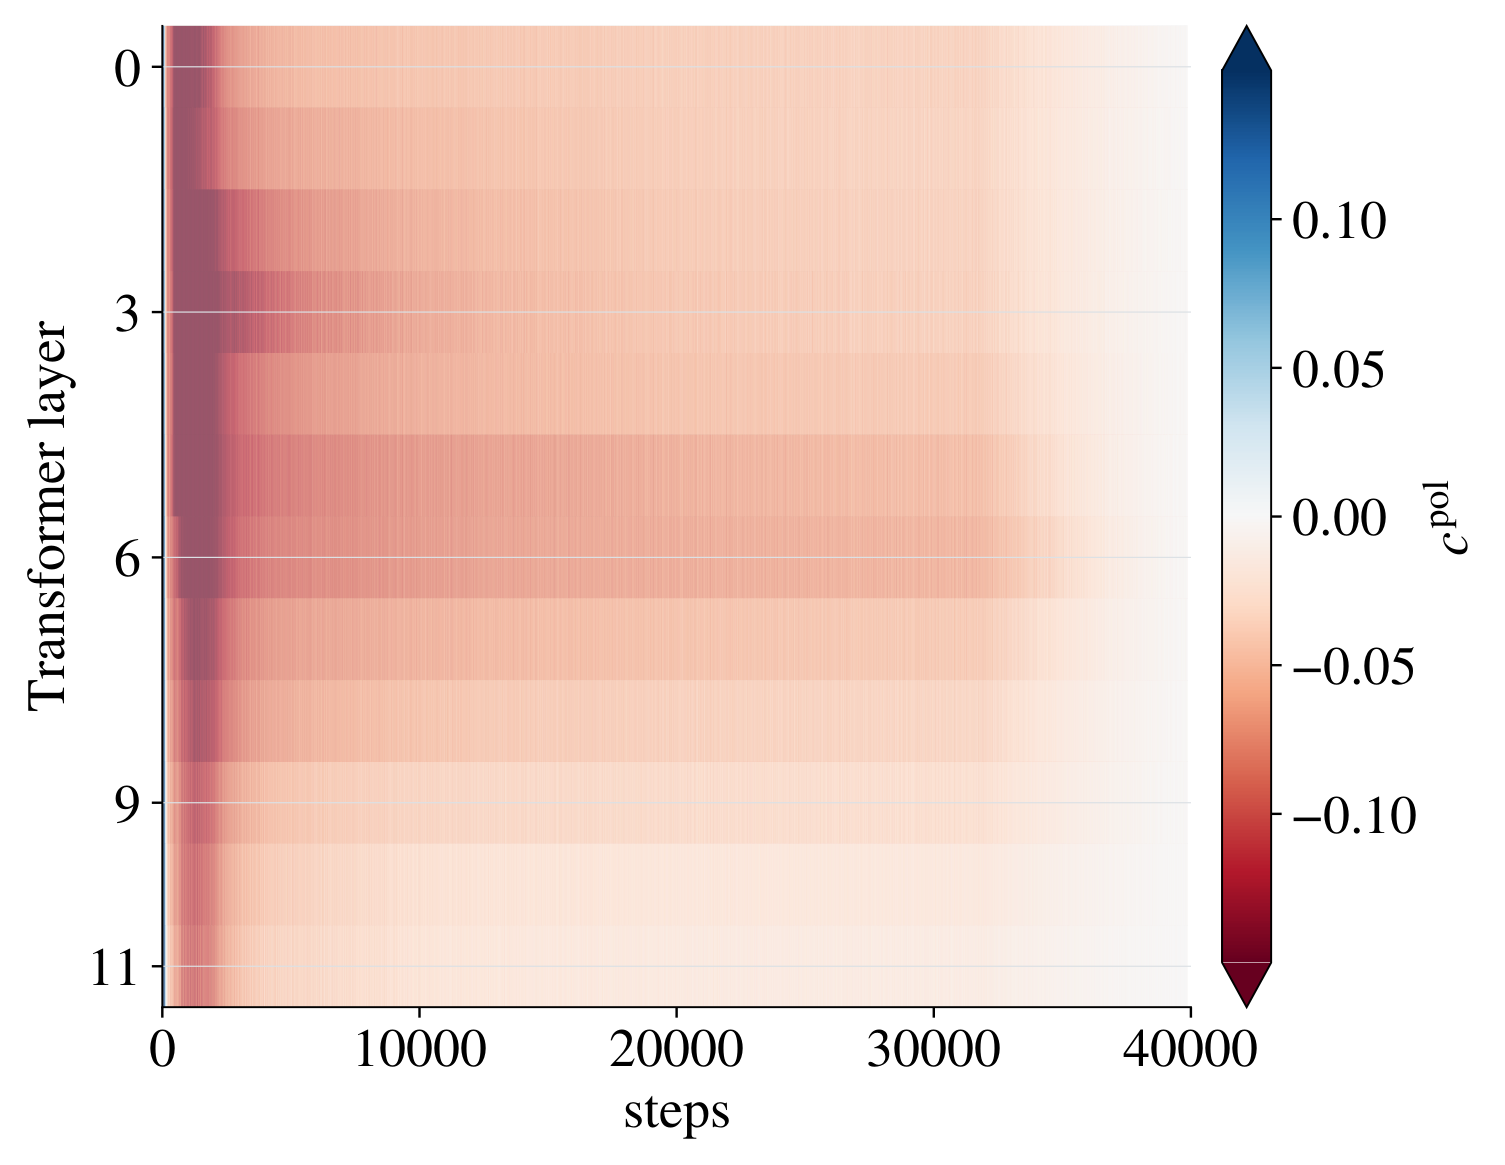
先看模型内部。在图 10 中,比较 key/value 矩阵块与 query 矩阵块,再跟踪其方向余弦随时间的变化。下面的相干性曲线则考察:增大探针批量时,损失侧信号如何改变?
哪些位置的负向对齐最强?
对齐程度如何随训练演化?
更大的探测批次保留更多方向一致性
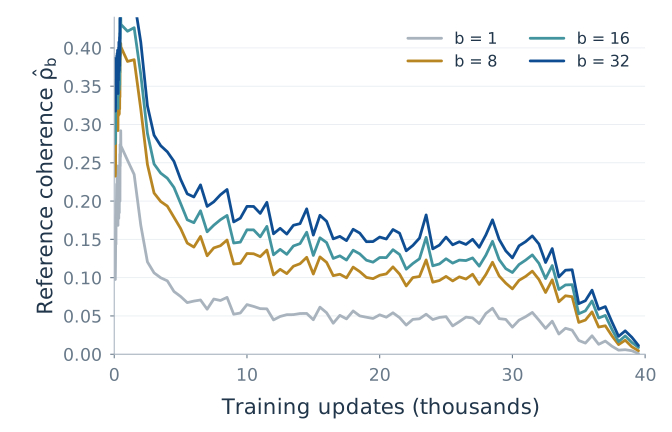
模块中位数帮助定位负对齐更强的位置;时间热图展示其演化;相干性曲线展示探针采样如何影响损失侧信号。中间层的 key/value 矩阵与许多 query 矩阵不同,而更大的探针批量通常具有更强的参考相干性。因此,全局余弦接近零的现象需要结合层与模块的结构一起解读。
近正交只是小批量随机性吗?
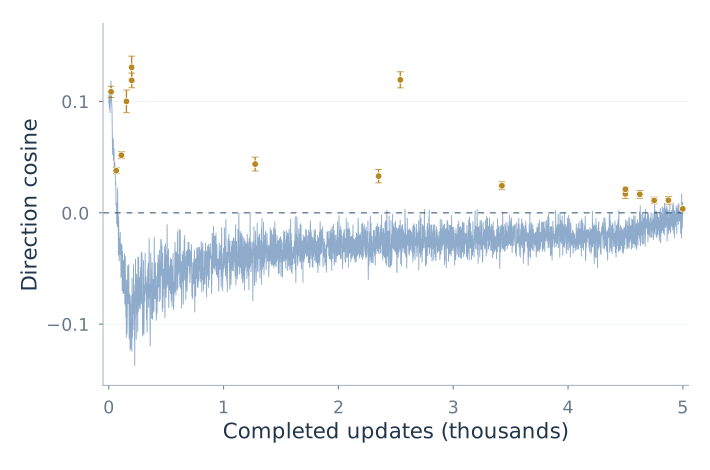
冻结状态实验有助于区分采样分散与时间反馈。在固定检查点,不推进模型,比较独立小批量产生的方向;然后将其与训练轨迹上连续两步的方向进行对照。
在同一检查点重新采样更新方向。
比较相邻状态下的更新方向。
随机种子 2026
随机种子 1337
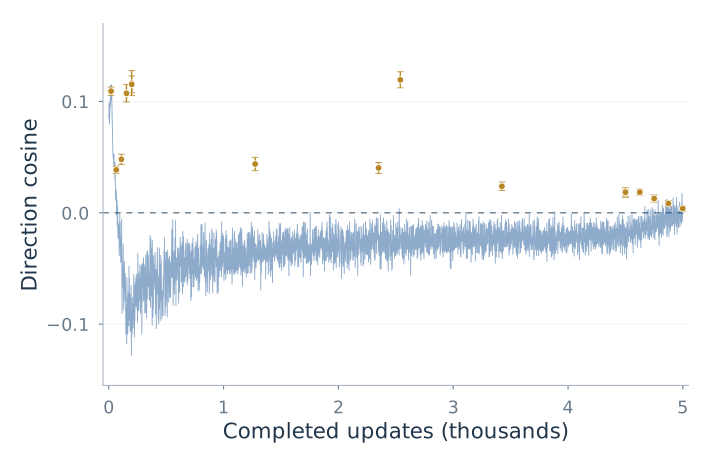
结果支持以下解释:采样分散是弱对齐的来源之一,而模型状态的变化是负向偏移的来源之一。Muon 和 AdamW 都会改变模型状态,因此该实验不能将反馈单独归于其中某个优化器。
1B 模型:更强的抵消下,损失仍在改善
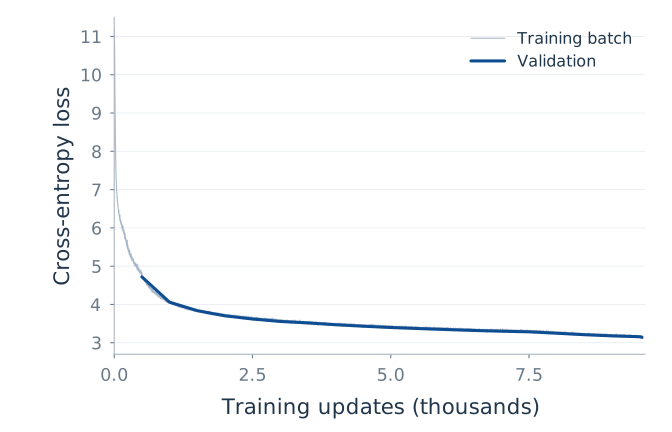
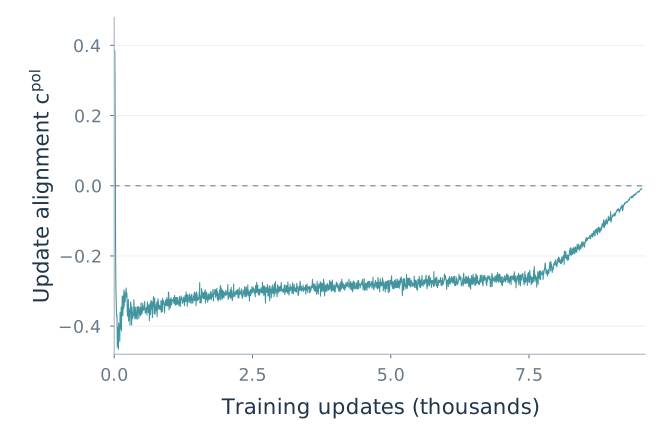
最后,图 12 在 1B 规模上再次展示损失与方向。该配置下余弦更负,但损失仍持续下降。逐层轨迹说明这种方向行为在模型内部的分布。
1B 模型仍在持续学习
更强的负向对齐
不同层呈现不同轨迹
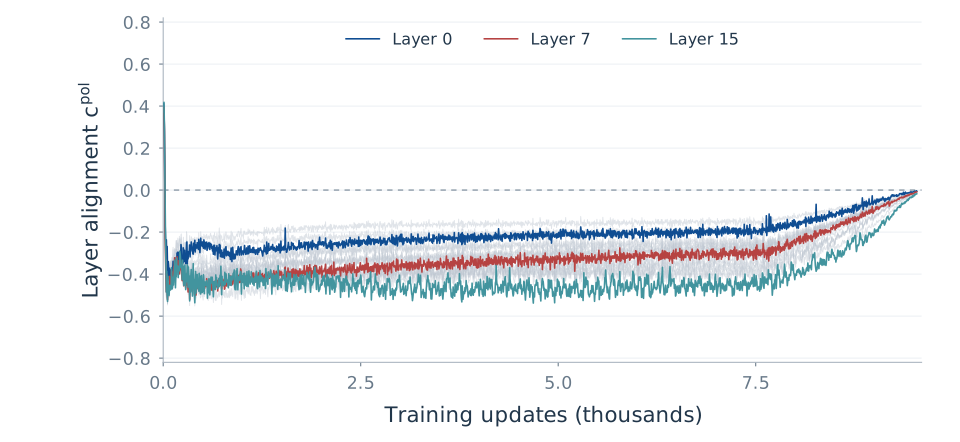
更大的批量与受控实验中的趋势一致,但从 130M 到 1B 同时改变了多个因素,无法单独分离批量大小的作用。1B 实验没有采集 T1 探针;它提供方向侧的证据,而不是对条件损失平衡的检验。
7. 哪些结构被保留?为什么称为“扬弃”?
Muon 保留了经相干性修正的损失平衡边界,同时改变了这一边界与时间方向反转的关系。 损失恒等式定义 T1,极几何使 T2 依赖另一种响应。矩阵例子证明两者可以分离;受控训练和语言模型实验则展示这种分离如何在实践中出现。
在 130M 规模上,损失边界追踪与弱负方向对齐并存。研究中的 1B 配置具有更强的部分抵消,但仍远离一致反转。逐层测量揭示了全局余弦掩盖的结构。由此得到一个分离的 EoS 图景:损失边界仍然存在,却不对应一种普遍的时间方向特征。
这就是本文中“扬弃”(sublates)的含义:保留经典图景中的重要部分,同时改变其内部结构。完整的随机扰动稳定性刻画是另一项数学任务;这里的损失与方向结果,明确了我们沿训练轨迹实际检验的特征。
这两个量能否指导学习率与批量大小的调度?
学习率分支实验引出了一个实际问题:能否利用测得的损失平衡和方向对齐,在训练过程中选择调度方案? 两个量提供互补信息:一个描述候选更新步如何权衡下降收益与曲率代价,另一个描述相邻方向如何相互加强或部分抵消。
对于损失侧信号,定义相对于条件平衡的偏离量
\[D_b(W;\eta)=s_b^M(W;\eta)-\frac{2\rho_b(W)}{\eta}.\]根据条件恒等式,\(D_b\) 为负表示所分析更新步的期望损失下降,为零表示损失平衡,为正表示期望损失上升。同时跟踪 \(c_k^{\mathrm{pol}}\),刻画时间方向响应。一步损失平衡与下一方向近乎正交是两种不同观察,调度器可以同时使用它们。
学习率:测量损失平衡如何移动
未来的调度器可以在选定检查点测试少量候选学习率,估计相应的条件损失变化,再通过短程续训观察方向余弦的响应。这沿用了检查点干预的思路:从同一状态出发,改变学习率可以使期望损失响应跨过零,而后续方向仍保持负向对齐。
对于预热—稳定—衰减(warmup–stable–decay,WSD)调度,这些测量可以帮助选择稳定阶段的学习率,并研究何时开始衰减。一种可能的目标是在损失边界附近选择合适区域,结合方向响应与验证集进展共同评估。有效曲率本身依赖候选更新步,因此应分别测量各个候选学习率,不能把测得曲率视为固定常数,直接代入边界方程求学习率。目前尚未建立最优目标或阶段切换规则。
临界批量大小:寻找收益递减的区域
批量大小会同时改变采样极方向的相干性和时间行为。受控实验已经显示,改变批量大小可以使 T1 与 T2 的出现顺序交换。相干性测量补充了另一面:增大批量,可能保留更多全梯度的一阶下降信号。
因此,一个自然的后续实验是:在固定检查点联合扫描学习率与批量大小。对每个候选批量测量损失侧平衡,再通过短程续训测量方向对齐。在相同 token 预算下比较验证损失改善,同时记录实际耗时。这样可以检验,更大批量是否仍能带来有效进展,还是主要使连续更新更加冗余或相互抵消更强。
在这一思路下,候选的临界批量大小(critical batch size)对应这样一个区域:继续增大批量,单位 token 或单位时间带来的改善开始呈现收益递减。相干性趋于饱和、方向对齐发生变化,可以帮助定位值得考察的区域。这些量是诊断线索;临界批量大小不能仅由 \(c=0\) 或 T1 单独定义。在训练中反复开展测量,有望支持批量大小与学习率的联合动态调度。
在检查点测量
探测候选学习率与批量下的条件损失平衡。
进行短程续训
跟踪方向对齐与验证损失的改善。
评估调度方案
在相同预算下比较学习率和批量选择,并在后续训练中重复测量。
这是两个诊断量的一种未来用途,目前还不是经过实验验证的调度器。新增的动量 Muon 与 AdamW 实验也提示了历史信息的重要性:它们持续的正向对齐,促使我们研究考虑优化器记忆的调度目标。本文的损失边界分析以无动量 Muon 为中心。
现在可以回到开头的问题。Muon 保留了有意义的损失平衡边缘,而它的矩阵几何改变了这一边缘与连续方向之间的联系。同时理解这两方面,有助于更完整地描述训练,也提供了可以用于研究调度的具体测量量。
论文、代码与延伸阅读
Yanzhe Chen、Qifang Zhao、Xiaoxiao Xu、Fanghui Liu:《Muon Sublates the Edge of Stability in LLM Pretraining》,arXiv v1。代码。
背景文献:Wu、Ma 和 E(2018);Cohen 等人(2021);Jordan 等人的 Muon 介绍;Bernstein 对 Muon 的推导。
更多几何演示:Neel Mishra 的 Muon 第一部分与 Newton–Schulz 第二部分。本文的示意图和几何插值均独立实现,没有嵌入外部演示素材。以问题推进的讲述与读图引导借鉴了 Central Flows,可展开技术细节的形式也参考了 Tri Dao 的 ReplaySSM 博客。
图 1 和图 6–12 使用提供的测量记录与矢量 PDF 图。有 CSV/JSONL 的部分从记录重新绘制;其余曲线保留原始绘图顶点,并依据 PDF 刻度校准。热图保留原始单元值。冻结状态实验的点估计和区间端点由所提供 PDF 恢复,未改变原区间。没有编造实验值或不确定性带。图 2 的来源单独标明;图 3–5 为精确构造或明确注明的解释性示意。标量动画固定曲率,用于展示 GD 阈值。干预表格依据论文表 2 与附录 C.3。详细假设与实验协议见论文。